こんにちは。大阪でシステム開発やWeb制作、業務システムの開発を行いながら、最近はローカルLLMの事業も立ち上げて研究開発を進めているオレンジソフトウェアです。
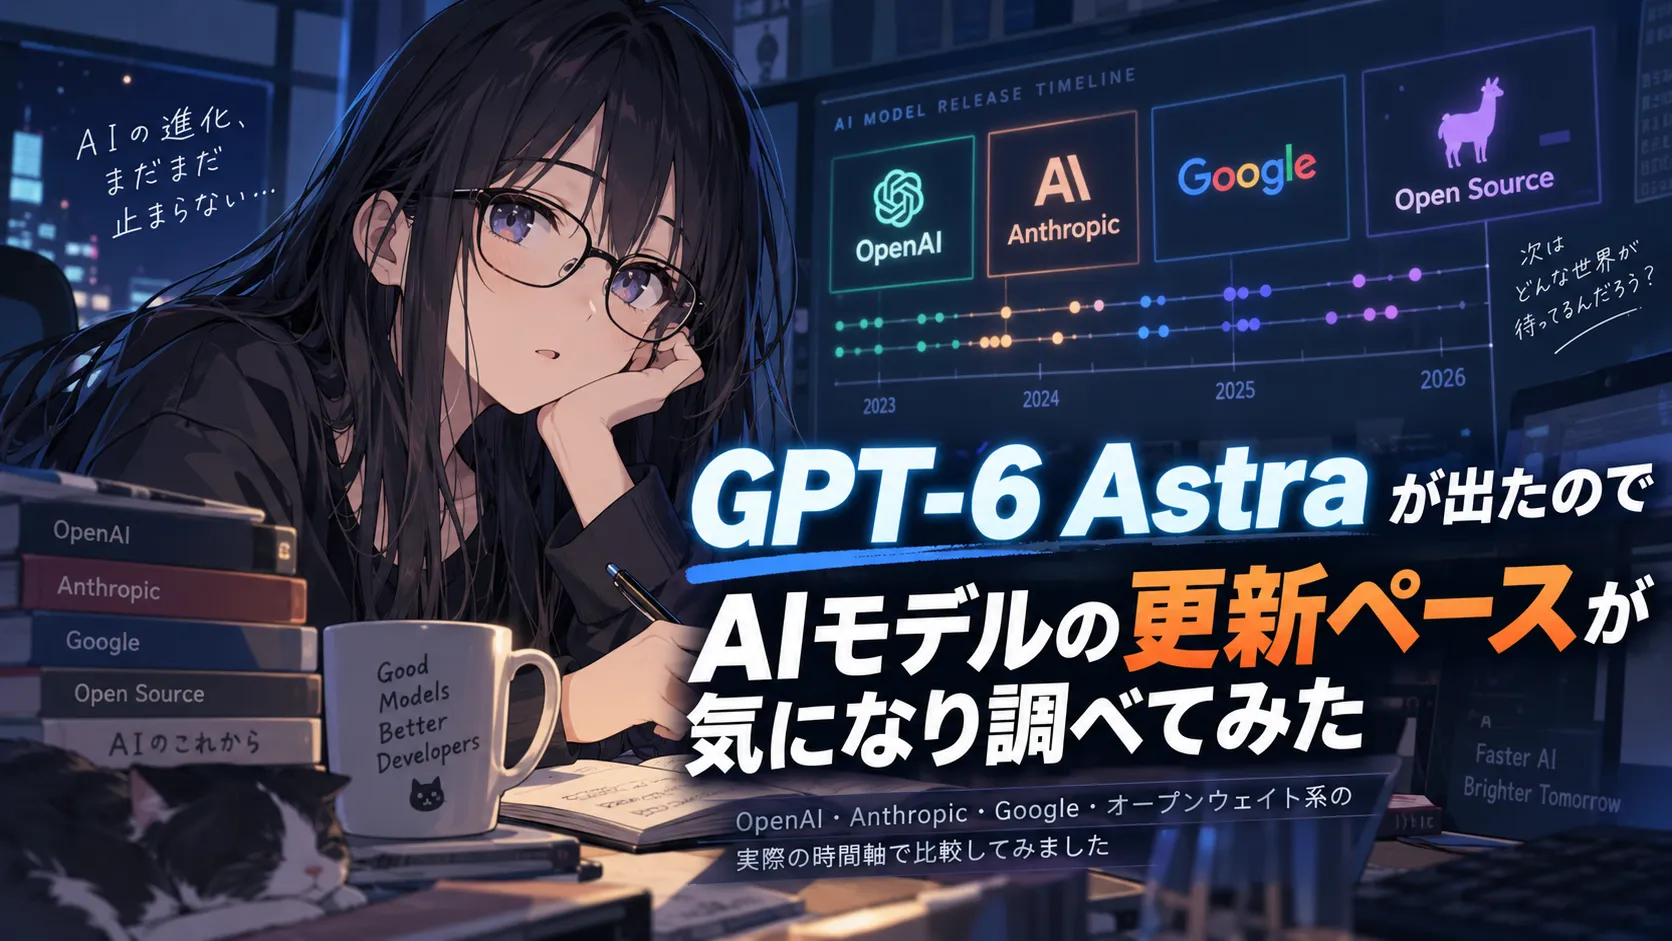
GPT-6 Astra が出たので
AIモデルの更新ペースが気になり調べてみた
2026年9月3日、OpenAIが GPT-6 Astra を発表しました。前世代のGPT-5.6が一般提供された7月9日から数えると、わずか56日です。
AI関連の仕事をしていると、「また新しいモデルが出た」というニュースをかなり頻繁に見るようになりました。数年前までは、大きなモデルの更新は一つのイベントとして追えましたが、最近は新モデル、派生モデル、コーディング特化、軽量版、オープンウェイト版まで含めると、少し目を離しただけで選択肢が入れ替わります。
オレンジソフトウェアでも、クラウドAIを実務に使い、現在はローカルLLMの研究開発も進めています。その立場からすると、単に「最新モデルを知っているかどうか」ではなく、いま何ができるのか、どのモデルをどの仕事に使うのがいいのかを定期的に見直すこと自体が業務になりつつあると感じます。
そこで今回、OpenAI・Anthropic・Google・オープンウェイト系の4系統について、代表的なモデルのリリース日を実際の時間軸に並べてみました。知りたかったのは「平均で何日おきに出ているか」という数字だけではありません。新しいものが出るペースが本当に加速しているのか。そして、その更新によってAIに任せられる仕事がどのように増えてきたのか。そこまで含めて、自分たちの現在地を確認してみます。
リリース年表(縦軸は実際の日数)
下に行くほど新しく、縦の距離は実際の経過日数に比例しています。単なる一覧表では分かりにくい「更新と更新の間隔」を視覚的に見るための年表です。2026年に入ると、各社の点が目に見えて密集しているのが分かります。
スマートフォンでは、系統名をタップするとその1列だけを画面幅で表示します。横スワイプでも見られます。
系統別の一覧
上の年表を、日付とモデル名で確認したい方向けの一覧です。見出しをタップすると各系統の表が開きます。ここでは大きな流れを追うため、代表的なマイルストーンだけを抜き出しており、すべての派生モデルや小規模アップデートを網羅しているわけではありません。
間隔はどう変わったか
上の年表に掲載した日付をもとに、同じ系統の前回リリースから次のリリースまでの日数差を年ごとに平均したものです。厳密な「各社の開発速度」ではありませんが、利用者側から見た更新頻度の変化はかなり分かりやすく表れます。
| 系統 | 2024年 | 2025年 | 2026年 |
|---|---|---|---|
| OpenAI | 156日 | 114日 | 53日 |
| Anthropic | 172日 | 87日 | 35日 |
| 124日 | 93日 | 60日 | |
| オープンウェイト系 | 95日 | 68日 | 27日 |
結果を見ると、2024年と比べて2026年の平均間隔は、おおむね3分の1から4分の1程度まで短くなっていました。体感として「更新が早すぎる」と感じていたのは、少なくとも数字の上でもある程度裏付けられます。
ただし、ここで注意したいのは、すべての点が同じ意味を持つわけではないことです。Anthropicの最短12日はOpus 4.6とSonnet 4.6という別ティアの連続投入で、完全な世代交代ではありません。Googleの最短23日も、3.6 Flashから3.7 Flashへの更新で、事前学習を最初からやり直したモデルではなく、アルゴリズム改善によるものです。つまり、「新しいモデルが出た」という一言の中には、世代交代、用途別モデル、軽量版、推論強化、アルゴリズム改善など、かなり性質の違う更新が混ざっています。
それでも、利用する側の負荷という意味では大差ありません。モデルが増えれば増えるほど、「この用途ならどれを使うのか」「クラウドで処理するのか、ローカルで処理するのか」「速度を取るのか、精度を取るのか」を選び直す回数が増えます。数が増えれば、それだけ「今の最適解は何か」を判断し直す必要があるということです。
システム開発会社として見ると、この影響はかなり直接的です。たとえばコード生成ひとつを取っても、数か月前に最適だったモデルが、そのまま現在の最適とは限りません。記事作成、資料作成、データ整理、社内検索、画像認識、エージェント処理など、用途によって有利なモデルも違います。モデルの性能比較だけでなく、料金、速度、コンテキスト長、外部ツールとの連携、ローカル実行の可否まで含めて考える必要があります。
しかも次の章で見るように、更新のたびに増えているのは「文章が少し賢くなること」だけではありません。AIに任せられる作業の種類そのものが増えています。ここが実務上は一番大きな変化で、単純なリリース間隔の数字以上に、仕事のやり方へ影響していると感じます。
数字の読み方について。この平均値は、どのリリースを拾ったかに強く依存します。年表は代表的なものだけを抜いており、GPT-5.1 Pro / Codex-Max、GPT-5.4 mini / nano、GPT-5.3-Codex-Spark、Gemini 3.5 Transcribe、Gemini Omni 1.1 といった派生・特化モデルは含めていません。これらを入れれば数字はさらに下がります。加速しているという方向そのものはどう取っても変わりませんが、絶対値は目安として読んでください。
日付の定義も揺れます。発表日・プレビュー開始日・一般提供日が別々のことが多く、ここでは原則として公式発表日を採りました。GPT-5.6は限定プレビューが6月26日、一般提供が7月9日で、後者を使っています。Claude Fable 5 / Mythos 5 は6月9日公開のあと6月12日に米商務省の輸出規制で全世界停止し、7月1日に復活しました。Gemini 3.5 Pro はI/Oで告知されたまま、8月下旬時点でも一般提供に至っていません。
オープンウェイト列はベンダー横断なので、1社の開発サイクルではなく「ローカルで動かせる選択肢が更新される頻度」として読むのが妥当です。中空の点は月精度でしか日付が取れなかったもので、その周辺の間隔は誤差を含みます。Gemma 4は資料によって4月2日と6月で割れており、ここでは一次情報リンクのある前者を採りました。
「チャットで答えを返すだけのAI」から何が変わったか
モデルの世代交代と並行して、AIに「何を」「どこまで」任せられるかも段階的に変わってきました。性能ベンチマークの数字より、実務で本当に効いてくるのはむしろこちらです。オレンジソフトウェアでも、AIの使い方はこの流れにかなり近い形で変化してきました。
会話する
チャット欄で質問して、返ってきた文章を読む。得られるのは文章だけなので、実際に使うには自分でコピーして貼り直す必要がありました。
任せる
コードの続きを提案するだけだったものが、リポジトリ全体を読み、テストを実行し、修正した差分まで返すようになります。MCPの登場で、外部ツールとのつなぎ方も統一されました。
形にする
PowerPointやExcel、Wordのファイルがそのまま出てくるようになります。社内の書式やテンプレートを読み取って、それに合わせて中身を書き換えることもできるようになりました。
手元で動かす
公開されているモデルの性能が実用に耐える水準まで上がりました。利用料金がふくらむことと、社外にデータを出せないこと。この二つの理由から、自社の環境で動かす選択肢が現実味を帯びてきます。
この四段階を、実際の出来事で追う2021年から2026年まで/22件
GitHub Copilot 技術プレビュー
まだ補完です。1行先を予測するだけで、仕事を任せる対象ではありませんでした。
ChatGPT 公開
ブラウザで返答を受け取る形が一般化。出口はテキストのみでした。
GPT-4 / Claude 1
画像入力に対応。文章の品質が実務で使える水準に近づきます。
ChatGPT Code Interpreter
チャットの中でコードを実行してファイルを返す。「返答」が「成果物」に変わる最初の一歩でした。
Devin 公開デモ
「AIソフトウェアエンジニア」を名乗った最初の製品。実態の評価は割れましたが、期待値の設定を変えました。
Claude 3.5 Sonnet + Artifacts
コーディング性能が跳ねたのと、生成物がチャットの外に置かれるようになったのが同じ日。コーディング実務投入と資料生成の、両方の起点だと考えています。
Cursor が急速に普及
エディタ側がAI前提の設計に変わりました。
ChatGPT Canvas / Claude computer use
編集できる面と、画面を操作する能力。
MCP 公開
外部ツールへの接続が共通規格に。ここから「エージェント」が実装可能な言葉になりました。
Claude Code 研究プレビュー
ターミナルからリポジトリを直接扱う。同じ月に「vibe coding」という語が広まります。
Codex CLI / Gemini CLI
各社がCLIエージェントを揃え、コーディング用途が横並びになりました。
gpt-oss 公開
OpenAIが久々にオープンウェイトを出しました。ローカル側の選択肢が一段厚くなった時点です。
Claude が pptx・xlsx を直接生成
資料そのものが出力形式になりました。
Claude for Excel ベータ / Skills
まずMaxとEnterprise向け。手順を再利用可能な形で持たせられるようになります。
Claude for Excel が Proプランに開放
個人契約でも表計算の中でAIが動くようになりました。
インテックがローカルLLM導入支援を開始
参考価格500万円から、最短1か月でオンプレ構築。SIerがローカルを商材として扱い始めた時期です。
Claude in PowerPoint
企業のスライドマスターやフォント、配色を認識した上で生成・編集する。資料作成が「叩き台づくり」から「既存資産の書き換え」に移りました。
AI事業者ガイドライン 第1.2版
総務省・経済産業省。データ管理とセキュリティ確保の要求が明文化され、オンプレ検討の後押しになりました。
Claude for Word / Gemma 4 が Apache 2.0 へ
Word・Excel・PowerPointでコンテキストを共有。一方でオープンウェイト側はライセンスが緩む方向に動きます。
DeepSeek-V4 Preview
100万トークンがオープンウェイトの標準になりました。
Ollama がシリーズBで65百万ドル調達 / NVIDIA DGX Spark 発売
ローカル実行のランタイムとハードの両方が揃います。
GPT-6 Astra
画面を操作して、文書・3Dモデル・出品作業までを通しで仕上げるデモ。人間の担当は目的の提示と結果の判断に寄っていきます。
オレンジソフトウェアの3年
ここまでの年表だけを見ると、AI業界の大きなニュースを時系列で並べただけにも見えます。ただ、オレンジソフトウェアで実際にAIを業務へ取り入れてきた経緯と重ねると、業界側の変化と自社側の変化がかなり素直に一致していました。
弊社はもともと、Webシステムや業務システムを開発する会社です。そのためAIも「面白い新技術」として眺めるより、実際の開発、調査、SEO、文章作成、資料整理などの中で、どこまで仕事に使えるかという視点で触ってきました。ここからは、2024年から現在までの約3年間を、自社の使い方の変化として振り返ります。
2024年:まずクラウドAIを持ち込んだ
2024年ごろ、まずクラウドAIとしてClaudeを業務に使い始めました。当時はまだ「便利そうだから試してみる」という位置づけで、社内の仕事すべてに組み込まれていたわけではありません。文章の下書き、調査、簡単なコードの相談など、従来の作業を少し速くするための補助ツールという感覚が強かったです。
ところが、使っていくうちに役割が少しずつ変わってきました。単に質問へ答えてもらうだけではなく、まとまったコードを書かせる、既存コードを読ませる、長い文章を整理させるといった使い方が現実的になっていきました。今この年表を見返すと、ちょうどAIが「補完」から「委任」へ移り始めた時期と重なっています。Claude 3.5 SonnetやArtifactsが登場し、AIに任せられる仕事の単位が大きくなったことで、弊社でも明確に手応えを感じるようになりました。
2025年:業務の一部として、無くてはならないものになった
2025年に入ると、AIは「あると便利」なものから「無いと困る」ものへ変わりました。特定の担当者が試す道具ではなく、日々の仕事の中で普通に使う前提になってきたということです。
この年は業界側でも、コーディングと資料生成の両方が一段実用的になった時期でした。Claude CodeやCodex CLIのように、リポジトリ全体を扱えるツールが揃い始め、AIが単にコード片を提案するだけでなく、複数ファイルを読み、修正し、テストまで含めて作業する方向へ進みました。さらにpptxやxlsxのような成果物そのものを生成できるようになり、チャットの回答を人間が手作業で転記する場面も減っていきます。
自社の使い方が大きく変わったのも、ほぼ同じ時期です。AIの性能が上がったから使う量が増えたのか、使う量が増えたから新しい用途が見えてきたのか、その両方だと思います。少なくとも2025年には、AIを抜きにして従来と同じやり方へ戻ることは現実的ではなくなっていました。
特に変化が大きかったのがSEO対策の領域です。弊社のSEO対策では、いまやAIは必須になっています。検索結果の調査、競合サイトの構造分析、記事構成の検討、既存ページの改善候補の洗い出し、内部リンクの整理、大量ページの点検など、SEOには「一つひとつは難しくないが、量が非常に多い」作業が数多くあります。
こうした仕事をすべて人力だけで回そうとすると、どうしても確認できる範囲に限界が出ます。AIを前提に作業工程を組み直すと、人間は「何を調べるか」「結果をどう判断するか」「本当にその修正を行うべきか」という判断に時間を使えるようになります。AIを入れたことで単に作業時間が短くなったというより、これまで手が回らなかった範囲まで調べられるようになったという変化のほうが大きいです。
逆に言えば、現在の業務量と品質を維持したままAIを外した運用へ戻すことは、かなり難しくなっています。便利な補助ツールだったものが、仕事の工程そのものに組み込まれたということです。
そして現在:ローカルLLMの事業を立ち上げた
AIが業務の前提になると、今度は別の問題が見えてきます。一つはコストです。使う量が増えれば、当然ながら利用料も増えます。特にAPIを業務システムへ組み込む場合、利用者数や処理件数に応じて従量課金が増えるため、便利になればなるほど月額費用が読みづらくなることがあります。
もう一つが、データの取り扱いです。クラウドAIを利用する以上、入力したテキストやファイルは外部の推論基盤を経由します。もちろん各サービスには法人向けのセキュリティ機能やデータ保護の仕組みがありますが、それでも「そもそも社外へ送信したくない」「契約や社内規程の都合で外部送信できない」というデータは存在します。顧客情報、社内文書、開発中の情報などを扱う用途では、この制約がAI活用そのものの壁になることがあります。
そこで現在、オレンジソフトウェアではローカルLLMの事業を立ち上げ、研究開発を進めています。ローカルLLMとは、クラウド上のAIサービスへ毎回データを送るのではなく、自社PCや社内サーバーなど、自分たちが管理する環境でLLMを動かす構成です。
目的は「何でもローカルに置き換えること」ではありません。外部へ出したくない情報を扱う処理や、同じような処理を大量に繰り返す用途について、自社の管理下で動かせる選択肢を持っておくことです。クラウドAIの便利さを知っているからこそ、その反対側にあるコストや情報管理の課題も見えてきました。そこで、手元で動かす技術を自社の中に蓄積しておこうと考えています。
この判断は、時期としても悪くないと考えています。年表のとおり、2025年8月のgpt-ossを皮切りにオープンウェイト側の性能が実用域に入り、2026年に入ってからはQwen3.5・3.6・3.8、Gemma 4のApache 2.0移行、DeepSeek-V4の100万トークン、Mistral Small 4やMedium 3.5と、選択肢が一気に厚くなりました。
さらに、モデルだけでなく周辺環境も整いつつあります。国内では2026年1月にSIerがローカルLLM導入支援を商材として出し、3月にはAI事業者ガイドラインが更新されています。実行環境もOllama・LM Studio・vLLM・llama.cppなどが揃い、専用GPUサーバーだけでなく、ユニファイドメモリを持つMacやDGX Sparkのような機器まで選択肢が広がってきました。
つまり以前のように「クラウドAIを使うか、AIを使わないか」という二択ではなくなっています。「クラウドか、ローカルか」ではなく、「どの処理をクラウドに残し、どの処理をローカルへ寄せるか」を設計できる段階になったというのが、現在の実感です。
もちろん、ローカルにすればすべて解決するわけではありません。GPUや大容量メモリを搭載した機器には初期投資が必要ですし、モデルの更新、推論環境の管理、バックアップ、アクセス権限など、クラウドサービス側に任せていた運用も自社で考える必要があります。また、最先端の大規模クラウドモデルと比べれば、複雑な推論や幅広い知識が必要な仕事では差が残る場面もあります。
そのため弊社では、最初から「全部ローカル」を目指すより、機密性が高い処理、繰り返し回数の多い処理、社内文書を検索するRAGのような用途をローカルへ寄せ、難易度が高く最新モデルの性能が必要な仕事はクラウドを使う、という併用が現実的だと考えています。どこで線を引けば、費用・性能・安全性のバランスが最も良くなるのか。その判断材料を増やすために、現在も実機でモデルを動かしながら検証を続けています。
インターネットのときと、たぶん同じことが起きている
今回調べてみた結果、数字だけで言えば「2026年は代表的な更新が27日から60日程度の間隔で出ている」という結果になりました。ただ、この記事を書きながら改めて感じたのは、間隔そのもの以上に更新の中身が変わったことのほうが重要だということです。
2024年ごろは、新モデルが出るたびに「前より賢くなった」「文章が自然になった」「コードが少し強くなった」といった性能向上が中心でした。ところが2025年から2026年にかけては、画面操作、ファイル生成、外部ツール連携、長時間のコーディング作業、社内データ検索など、AIが担当できる作業そのものが増えています。
増えているのが単なるベンチマークスコアではなく、任せられる仕事の種類なので、新しい能力が増えるたびに「この作業もAIへ移せるのではないか」と業務フローを見直す必要が出てきます。追いかける負荷が高くなっている一番の理由は、モデル数が増えたことよりも、こちらだと思います。
この感覚には、インターネットが普及していった時期と少し似たものがあります。インターネットによって、情報の探し方、広告の出し方、問い合わせの受け方、商品を売る場所、社内の連絡方法まで、仕事の前提が少しずつ置き換わっていきました。最初は「あると便利」だったものが、気がつけば「無いと仕事にならない」インフラになっています。
AIも、同じ方向へ進んでいるように見えます。ただし違うのは、その変化の速度です。インターネットの普及は数年単位で進んだのに対し、AIは数か月単位で能力や使い方が変わります。同じような規模の転換が、もっと短い時間で進んでいるというのが、実際に仕事へ組み込んでいる側から見た実感です。
これは意欲の話ではなく、置いていかれないための必要条件です。
新しいモデルが出たら、ニュースを読むだけで終わらせず、できる範囲で実際に触ってみる。新しい機能が出たら、自社のどの業務に当てはまるのかを試してみる。ローカルLLMの研究開発も、その延長線上にあります。
AIは、紹介記事やベンチマークを読むだけでは実務での使い勝手が分かりにくい技術です。実際のコードを読ませたらどうなるのか、日本語の長文を扱わせたらどうなるのか、社内文書を検索させたらどうなるのか。自社の仕事に近い条件で動かしてみて初めて、「これは使える」「ここはまだ人間がやったほうがいい」という判断ができます。この記事のように、気になったことを自分で調べて整理するのも、そのための学習の一部です。
とはいえ、すべてのモデルや機能を追い続ける必要はないとも考えています。毎週のように出てくる更新を全部試していたら、それだけで本来の仕事が止まってしまいます。
大事なのは、自社の業務でいま詰まっている部分に対して、それを解決できる更新が来たかどうかを見ることだと思います。開発に時間がかかっているならコーディング性能を見る。社内文書を探すのが大変ならRAGや長文コンテキストを見る。クラウド利用料が増えているならローカル実行を見る。機密情報を扱えずAI活用が止まっているなら、オンプレミスやローカルLLMを検討する。
そう考えると、「最新モデルを全部覚える」ことが目的ではなくなります。自社の課題と、新しくできるようになったことを結び付けられる状態を保つ。そのために必要な範囲で学び続ける。今回の年表は、オレンジソフトウェアにとってその現在地を確認するための整理になりました。